Crawl4AI 是什麼?免費開源、專門把網頁變成餵 AI 資料的爬蟲
編輯:BJ最後檢查:2026-06-02主要來源:GitHub
Crawl4AI 是 GitHub 上很紅的開源網頁爬蟲,專門把網頁抓下來、轉成乾淨的 Markdown 餵給 AI。這篇用新手角度說明它能幹嘛、跟 Firecrawl 差在哪、要不要錢、什麼人適合用,以及爬網頁前要注意的風險。
Crawl4AI 想解決什麼問題
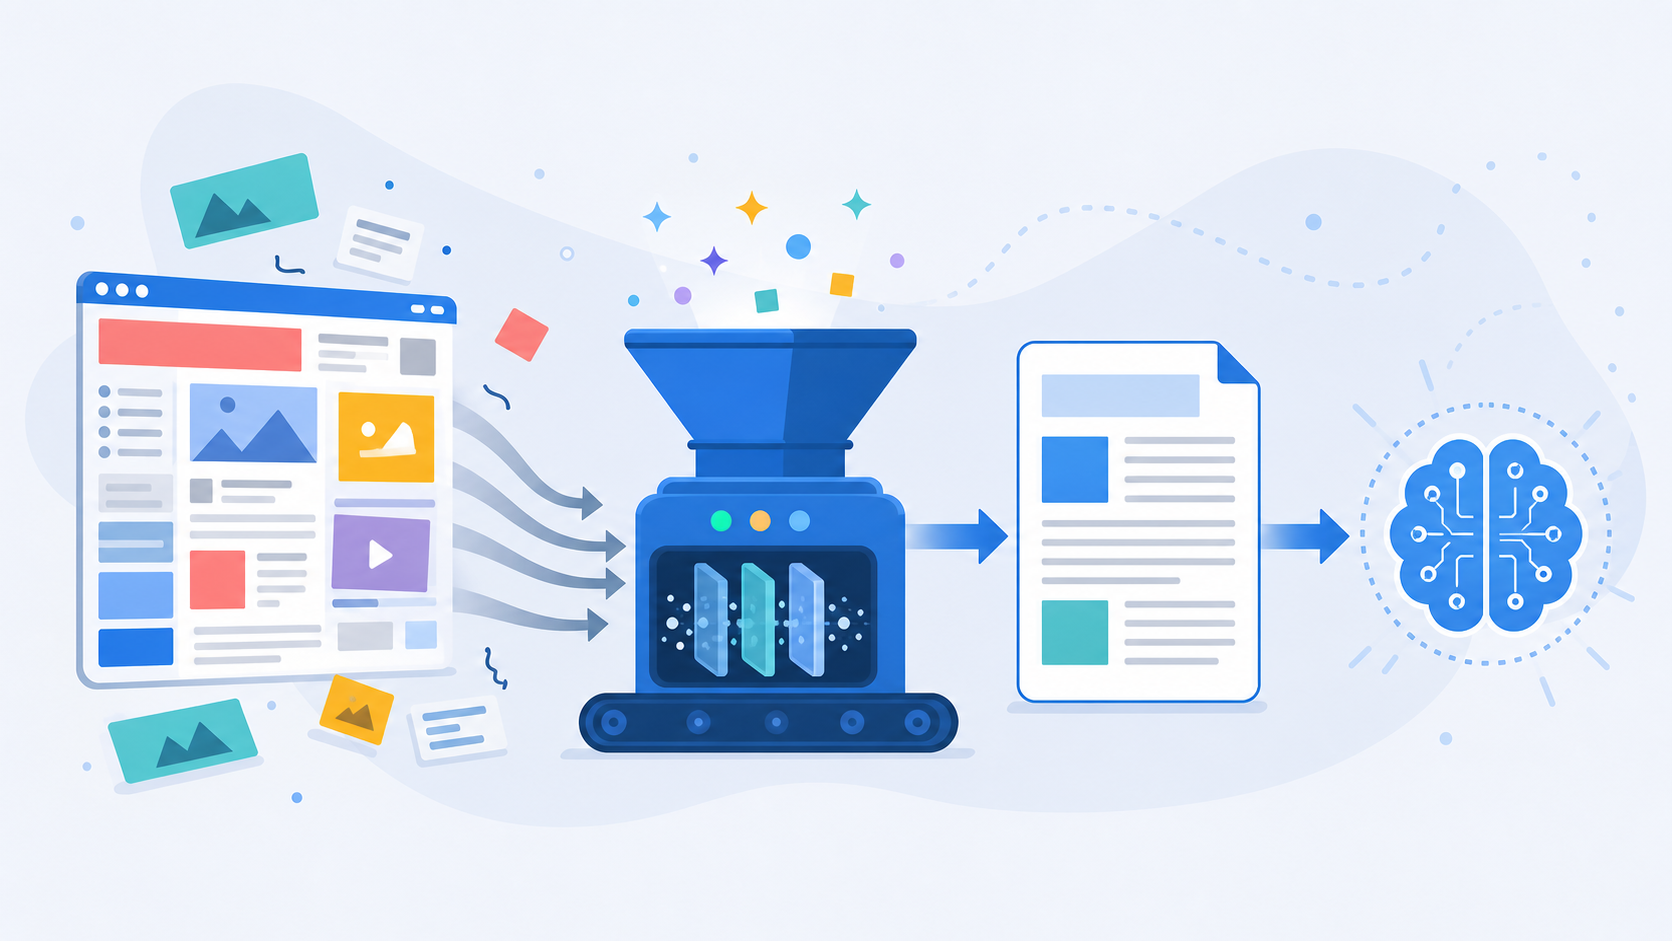
你想讓 AI 讀某個網站的內容、整理某些網頁的資料,但直接把網址丟給 AI,它常常讀不到、或讀進一堆網頁的雜訊(廣告、選單、側欄)。
Crawl4AI 想解決的就是這一段。它是一個專門「把網頁抓下來、清乾淨、轉成 AI 好讀格式」的開源爬蟲。你給它網址,它幫你把網頁內容抓回來,整理成乾淨的 Markdown(一種純文字結構格式),這種格式正好是 AI 模型最容易消化的。
它在 GitHub 上非常紅,一度衝上趨勢榜第一,星數五萬以上。重點是它完全開源免費(採 Apache-2.0 授權),沒有強制要你申請 API Key、也沒有付費牆,這是它跟一些商業爬蟲服務最大的不同。
它跟 Firecrawl 差在哪?
這是最多人會問的,因為 Firecrawl 做的事很像:都是「把網頁變成餵 AI 的資料」。差別在它是服務還是工具、誰在出力。
Firecrawl 主打「託管服務」。你申請帳號、拿 API Key,把網址丟給它的雲端,它幫你處理好回傳結果。好處是省事、不用自己架,但它是按用量計費的服務。
Crawl4AI 是「自己跑的工具」。它是一個 Python 套件,跑在你自己的電腦或伺服器上,不必把網址送到別人的雲端,也沒有按次計費。好處是免費、資料和流程都在你手上;代價是你要自己會裝 Python、自己跑。
簡單分:想省事、不想碰程式、願意付服務費 → Firecrawl;想免費、想自己掌控、不介意寫一點 Python → Crawl4AI。它常被當成 Firecrawl 的開源免費替代來用。
它實際能做哪些事?
Crawl4AI 的核心是「抓網頁、清乾淨、輸出 Markdown」,但它的功能比想像中多:
把網頁內容抓下來,自動去掉雜訊,輸出乾淨的 Markdown,直接可以餵給 AI 或存進知識庫。
可以同時抓很多個網址,平行處理,速度比一頁一頁抓快。
支援用 CSS、XPath 規則做精準抽取,也能用 AI 的方式抽出你要的結構化資料(例如把一頁商品清單抽成表格)。
用真實瀏覽器去抓,能處理需要載入、需要互動的現代網頁,也能設定代理、處理需要登入的情況。
對很大的表格有特別處理,能把巨大表格切塊抽取。
要注意一點:Crawl4AI 負責的是「把資料弄乾淨」,它本身不會「幫你回答問題」。要做到智慧抽取或問答,還是要接一個 AI 模型,這牽涉到成本,下面會講。
最重要的一段:免費,但不等於零成本
很多人看到「開源免費、不用 API Key」就以為完全不花錢,這裡要說清楚。
Crawl4AI 這個工具本身免費,純粹抓網頁、轉 Markdown 這部分確實不用付錢。
但實際的工作常常需要更多。如果你要用「AI 抽取」功能,讓它從網頁裡聰明地抽出結構化資料,那它背後要接一個語言模型,這個模型是要錢的(接雲端 GPT、Claude 按用量計費,或自己跑本機模型吃硬體)。另外,如果你把它架在雲端主機上大量、長期跑,主機費用也算成本。
所以「免費」的正確理解是:軟體本身免費、基本抓取免費,但「接 AI 做進階抽取」和「大規模長期運行」會有它們各自的成本。對輕度、自己電腦上跑的使用者,這通常很省;對要大量抓取的人,要自己算清楚。
爬網頁前,這些風險要先知道
爬蟲是把雙面刃,工具本身中性,但怎麼用會牽涉到該不該、合不合規。新手用之前,這幾點請先放在心上。
第一,尊重網站規則。很多網站有 robots.txt 或使用條款,會說明哪些內容能不能被自動抓取。大量、頻繁地爬一個網站,可能違反它的條款,也可能對它的伺服器造成負擔。
第二,不要爬個資和受保護內容。抓公開資料是一回事,抓涉及個人隱私、需要登入授權、或有版權的內容,可能有法律風險。
第三,爬下來的資料準不準要自己判斷。網頁內容本身可能過時、錯誤、或是別人的觀點。Crawl4AI 只負責把它抓乾淨,不負責保證內容是對的。
第四,頻率要節制。一次開很多平行抓取雖然快,但對目標網站不友善,也容易被擋。新手先小量、慢慢來。
簡單說:抓你自己的網站、抓明確開放的公開資料,相對安全;大規模抓別人的站、抓敏感內容前,先確認規則和法律。
它適合誰?又不適合誰?
比較適合:會一點 Python、想自己掌控爬取流程的人;要把網頁內容餵進 AI、做知識庫或 RAG 的人;不想為爬取服務付月費、願意自己架的人;資料量大、在意每次計費的人。
現階段不太適合:完全不會寫程式、看到 Python 就卻步的人(那 Firecrawl 這類服務更省事);只是偶爾要抓一兩頁、用瀏覽器複製貼上就夠的人;需要抓敏感或受保護內容、卻不確定合不合規的人。
怎麼低風險試第一次?
不要一開始就拿它去大量爬別人的網站。比較安全的順序是這樣。
先確認電腦能跑 Python,照官方文件把 Crawl4AI 裝起來,跑官方的入門範例,抓一個你自己的或明確公開的網頁,看它輸出的 Markdown 乾不乾淨。
先只用「抓網頁轉 Markdown」這個基本功能,不要急著接 AI 抽取,先確認基本流程順。
要用 AI 抽取時,先用便宜的模型、小範圍試,看抽出來的結構對不對,順便感受一下成本。
確認流程和成本都在你接受範圍,再考慮較大規模的使用。任何時候都記得控制抓取頻率、尊重對方網站的規則。
我會這樣建議新手
Crawl4AI 很值得認識,它代表「把網頁變成 AI 養分」這件事,現在有了強大又免費的開源選擇。對會一點程式、想自己掌控、又不想付服務費的人,它是 Firecrawl 很有力的替代。
如果你完全不碰程式,只是偶爾要讓 AI 讀個網頁,先用 Firecrawl 這類服務,或直接複製貼上,會比硬學 Crawl4AI 實際。等你有「自己掌控、量大、想省服務費」的需求,再來認真學它。
最重要的不是它多強,而是用它的時候有沒有守住規矩:尊重網站規則、不抓敏感內容、控制頻率。把這幾件顧好,它會是很實用的資料工具。
資料來源
本文依 Crawl4AI(unclecode/crawl4ai)官方 GitHub、官方文件與一般網頁爬取知識整理。Crawl4AI 功能與授權更新很快,正式使用前請再確認官方頁面,並遵守目標網站的使用條款與當地法律。
- https://github.com/unclecode/crawl4ai
- https://docs.crawl4ai.com/
延伸閱讀
Firecrawl 是熱門的開源網頁抓取工具,可以把網站內容整理成 Markdown 或結構化資料,常被放在 AI agent、RAG、知識庫與資料蒐集流程前面。這篇用新手角度說明它能幹嘛、適合誰、跟 MarkItDown 和 browser-use 怎麼分。
browser-use 是什麼?讓 AI 自己操作瀏覽器的熱門開源工具browser-use 是熱門的開源瀏覽器自動化工具,主打讓 AI agent 可以看網頁、點按鈕、填表單、完成網站任務。這篇用新手角度說明它好不好上手、適合哪些任務,以及跟 Playwright、Firecrawl 差在哪。
MarkItDown 是什麼?把 PDF、Word、PPT 轉成 AI 好讀 Markdown 的熱門工具MarkItDown 是 Microsoft 開源的檔案轉 Markdown 工具,適合把 PDF、Word、PPT、Excel、圖片等資料先整理成 AI 比較好讀的格式。這篇用新手角度說明它怎麼開始、放在哪種 AI 工作流、跟 Docling 怎麼選。
Cline CLI 是什麼?把 coding agent 搬到終端機,還能同時跑好幾個Cline 不只有 VS Code 外掛,還有一個從頭重寫的終端機版本,可以在 CLI 裡跑 agent、丟進 CI、甚至開一個看板同時派好幾個 agent 各做各的,這篇說明它跟外掛版差在哪、怎麼裝、以及什麼時候該用哪個
規則寫在 CLAUDE.md 它還是照做錯?問題不在記不住,在沒生效你在 CLAUDE.md 裡寫了規則,agent 照樣做成別的樣子;三天前裁定過的事,今天它拿舊版本回答你,這篇說明為什麼「幫 AI 加記憶」解不掉這件事,以及 Epitype 這類治理層在做什麼、要不要錢、什麼人不用碰
Kilo Code 是什麼?從 Cline 這條線長出來的開源 AI coding agentKilo Code 是 Cline 這條家族樹上目前最活躍的分支,MIT 授權、VS Code 和 JetBrains 都能裝、接得到五百多種模型而且不加價,2026 年 7 月被 Anaconda 收購後仍維持開源,這篇說明它跟 Cline 差在哪、什麼人該換過去、以及收購之後要留意什麼